NVIDIA BioIR, 4,777개 프로테옴 분석 가속; Redis LangCache, LLM 비용 90% 절감 및 15배 속도 향상
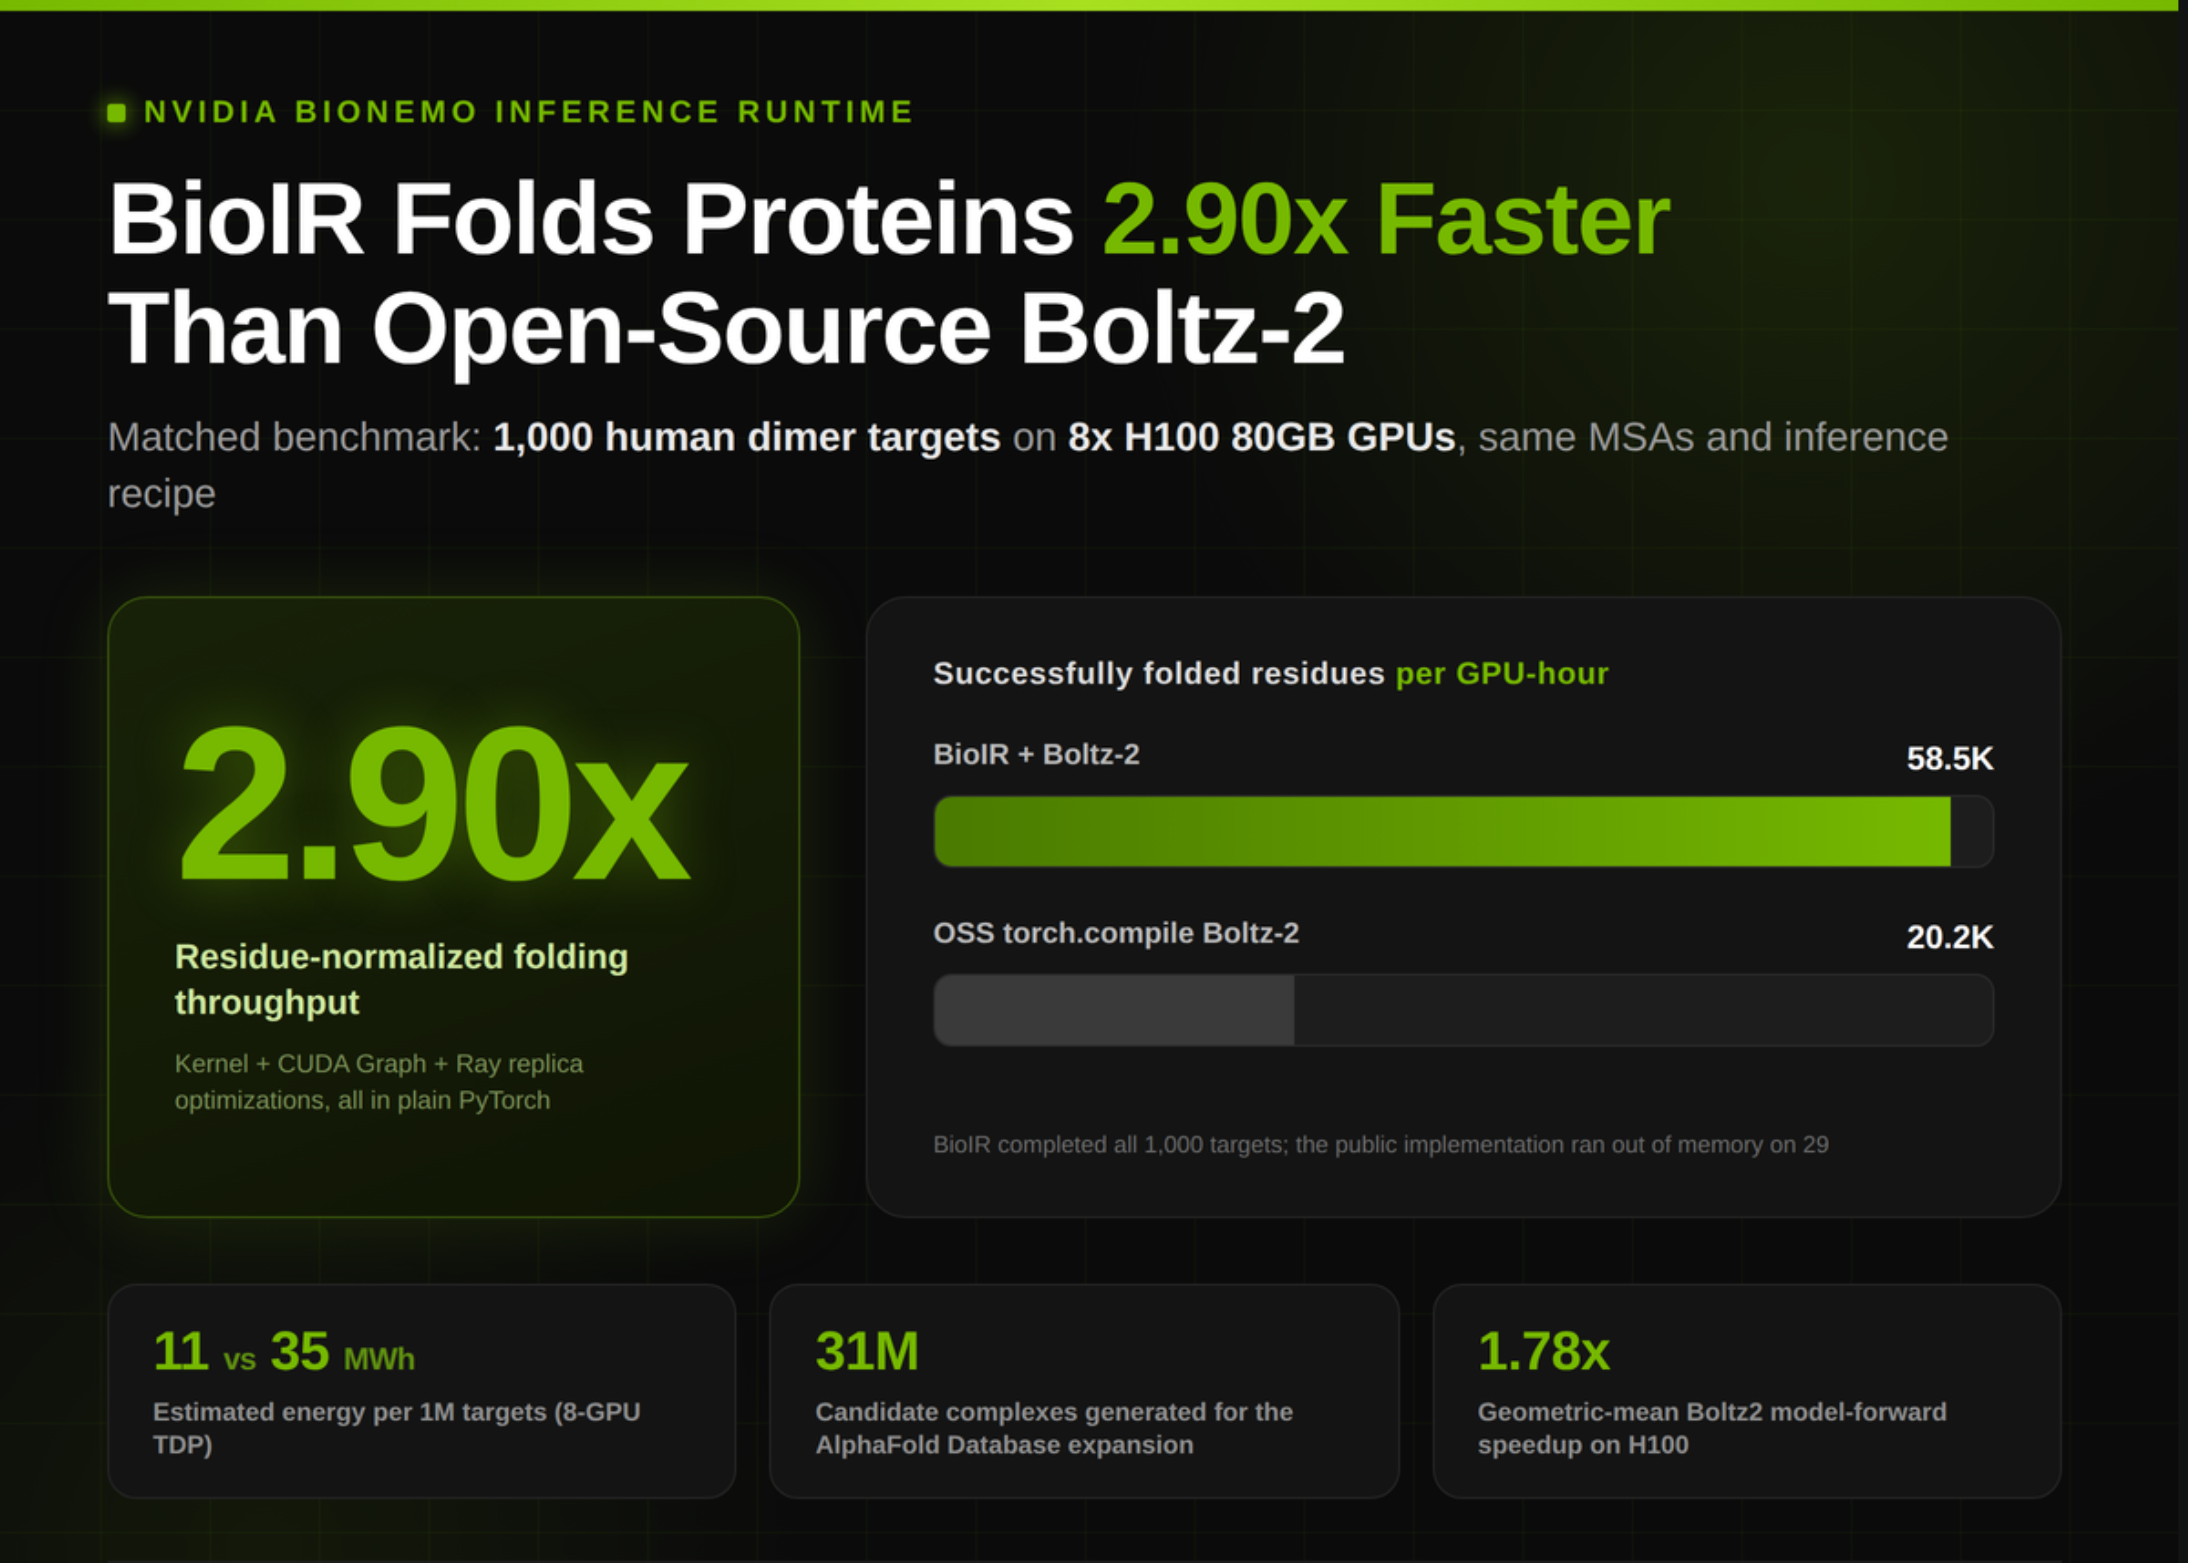
NVIDIA가 생체 분자 구조 예측 워크플로우 가속화를 위한 BioNeMo Inference Runtime (BioIR) 라이브러리를 공개했다. 동시에 Redis는 대규모 언어 모델(LLM) 애플리케이션의 비용 및 응답 속도를 최적화하는 LangCache를 선보이며 AI 모델 배포 및 운영 효율성 증대에 중점을 둔 솔루션들을 제시했다. 핵심 기술 사양 및 성능 분석 NVIDIA BioNeMo Inference Runtime (BioIR)은 단일 타겟을 넘어 프로테옴 규모의 생체 … 더 읽기
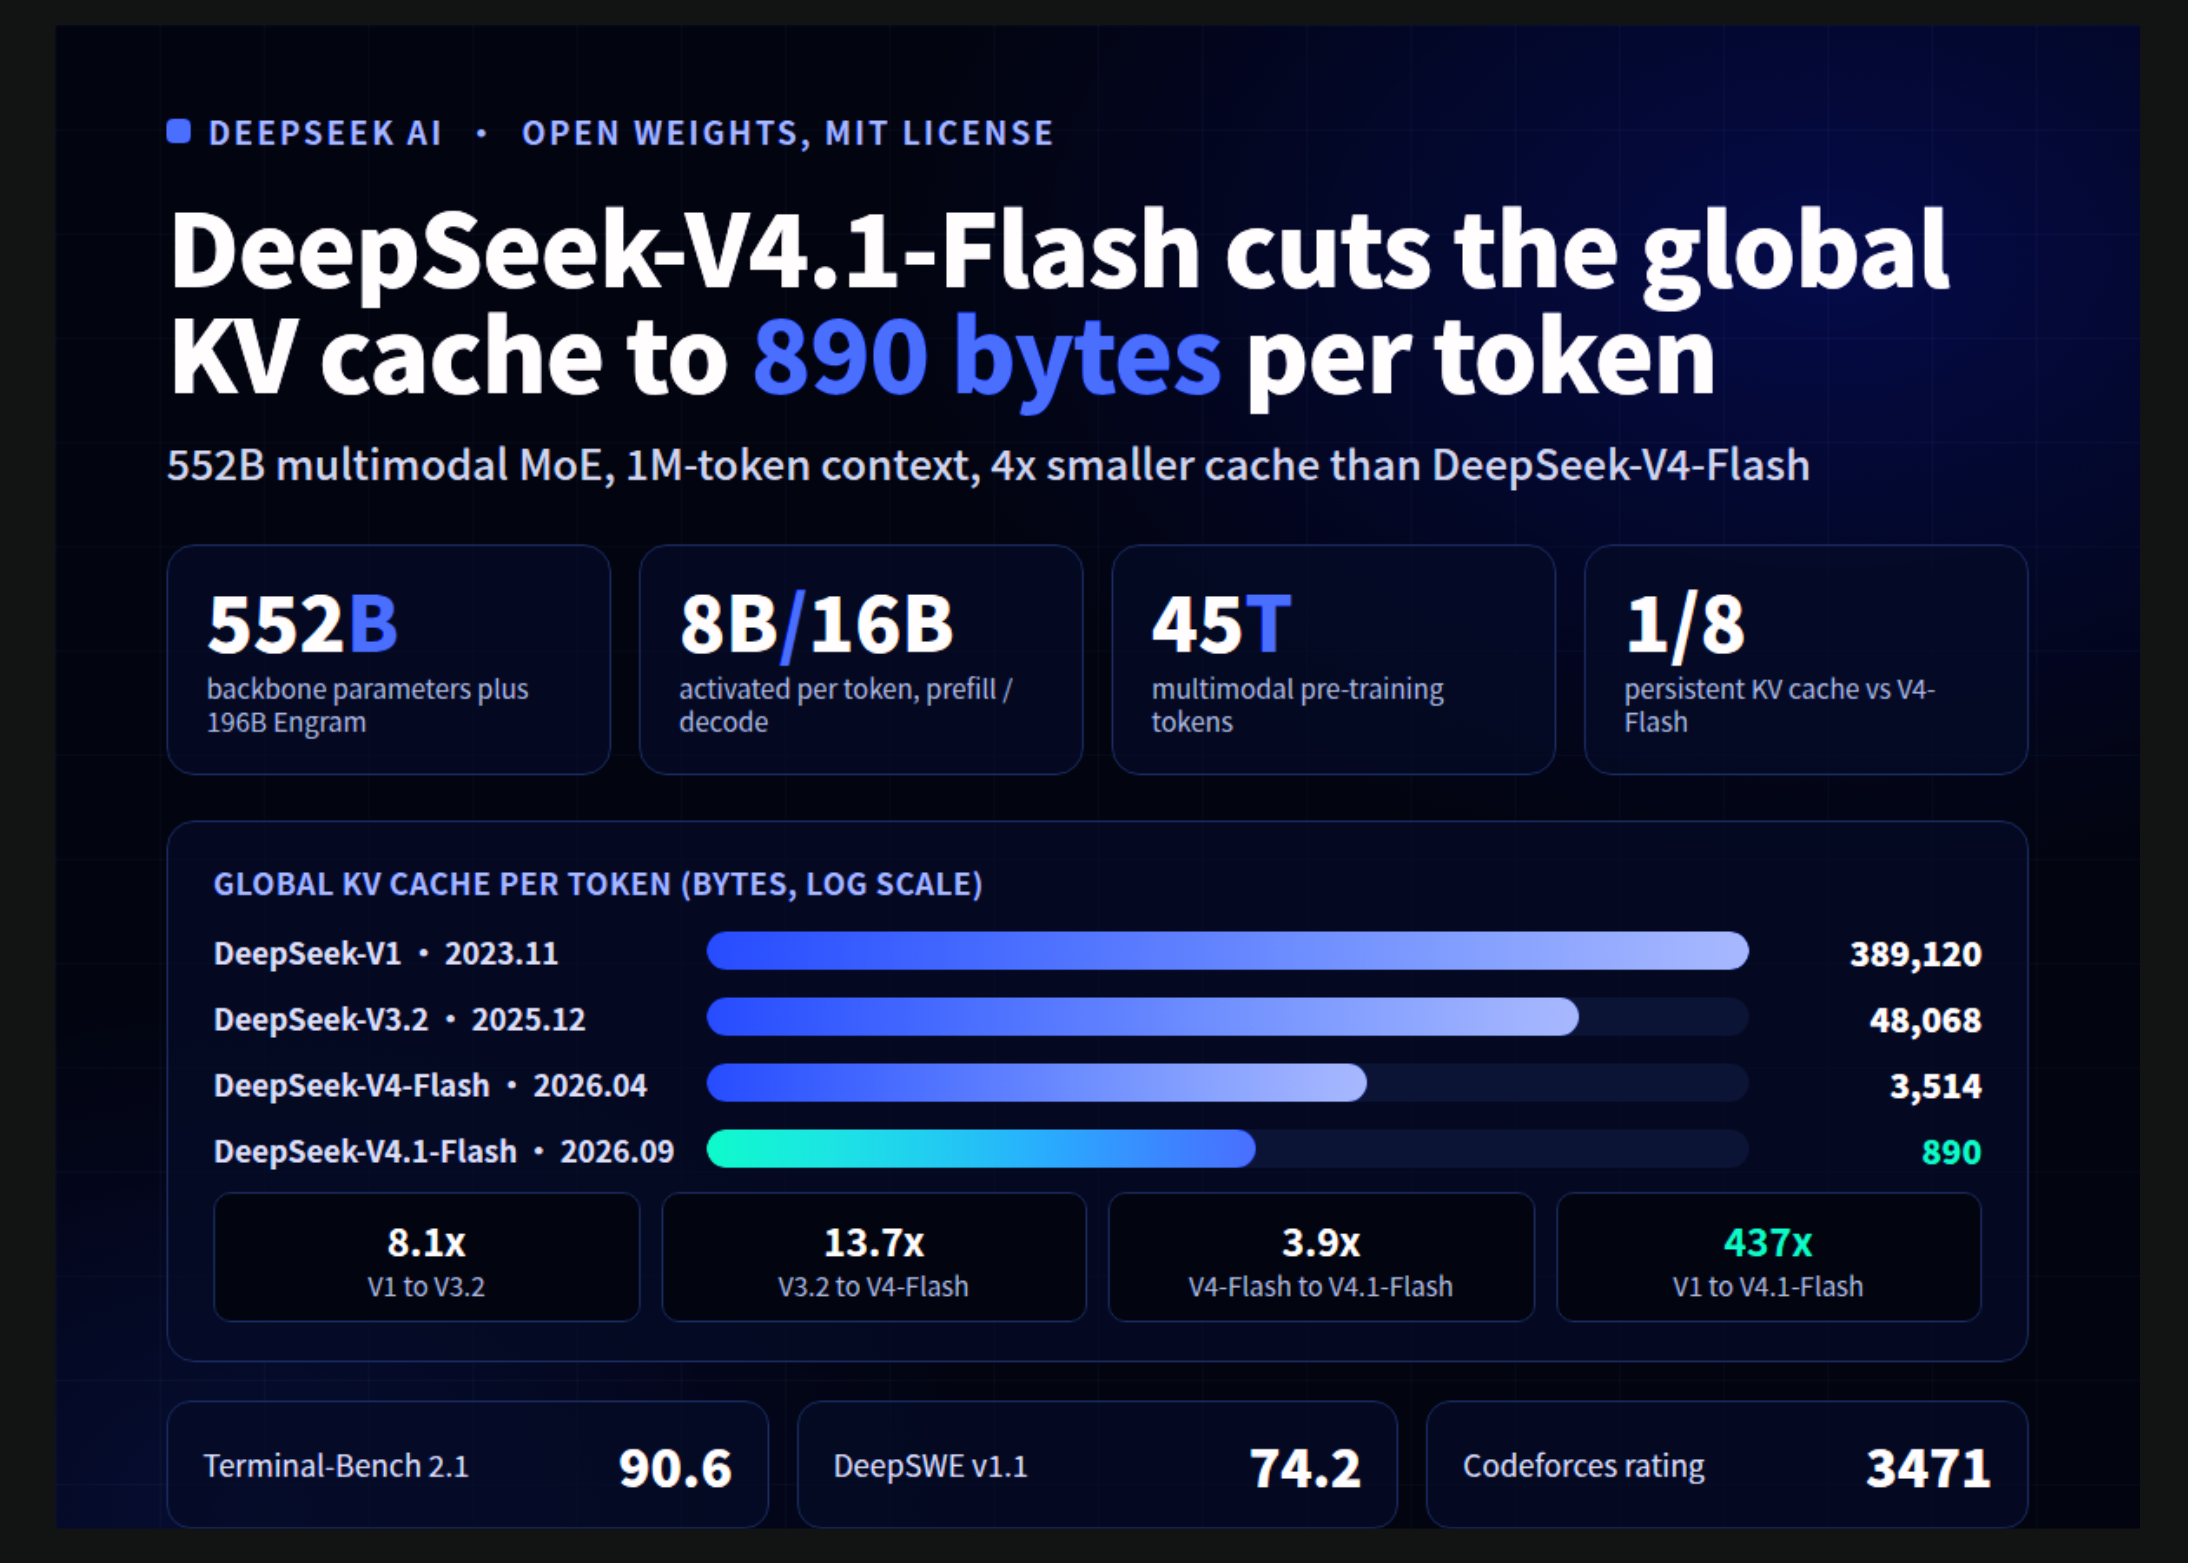
DeepSeek-V4.1-Flash, KV 캐시 효율 437배 개선; Apple, 오디오 AI에 Secure Exclave 적용

DeepSeek AI가 장기 컨텍스트 대규모 언어 모델(LLM)의 고질적 문제인 KV 캐시 부하를 대폭 줄인 DeepSeek-V4.1-Flash 모델을 공개했다. 동시에 Apple은 WatchOS의 새로운 오디오 AI 기능에 Secure Exclave 기반의 하드웨어 보안 아키텍처를 도입하여 사용자 프라이버시 보호를 강화했으며, Suno는 음원 제작 AI 모델 v6를 출시하며 장르 이해도에서 개선을 보였다. 핵심 기술 사양 및 성능 비교 DeepSeek-V4.1-Flash는 멀티모달 Mixture-of-Experts(MoE) … 더 읽기