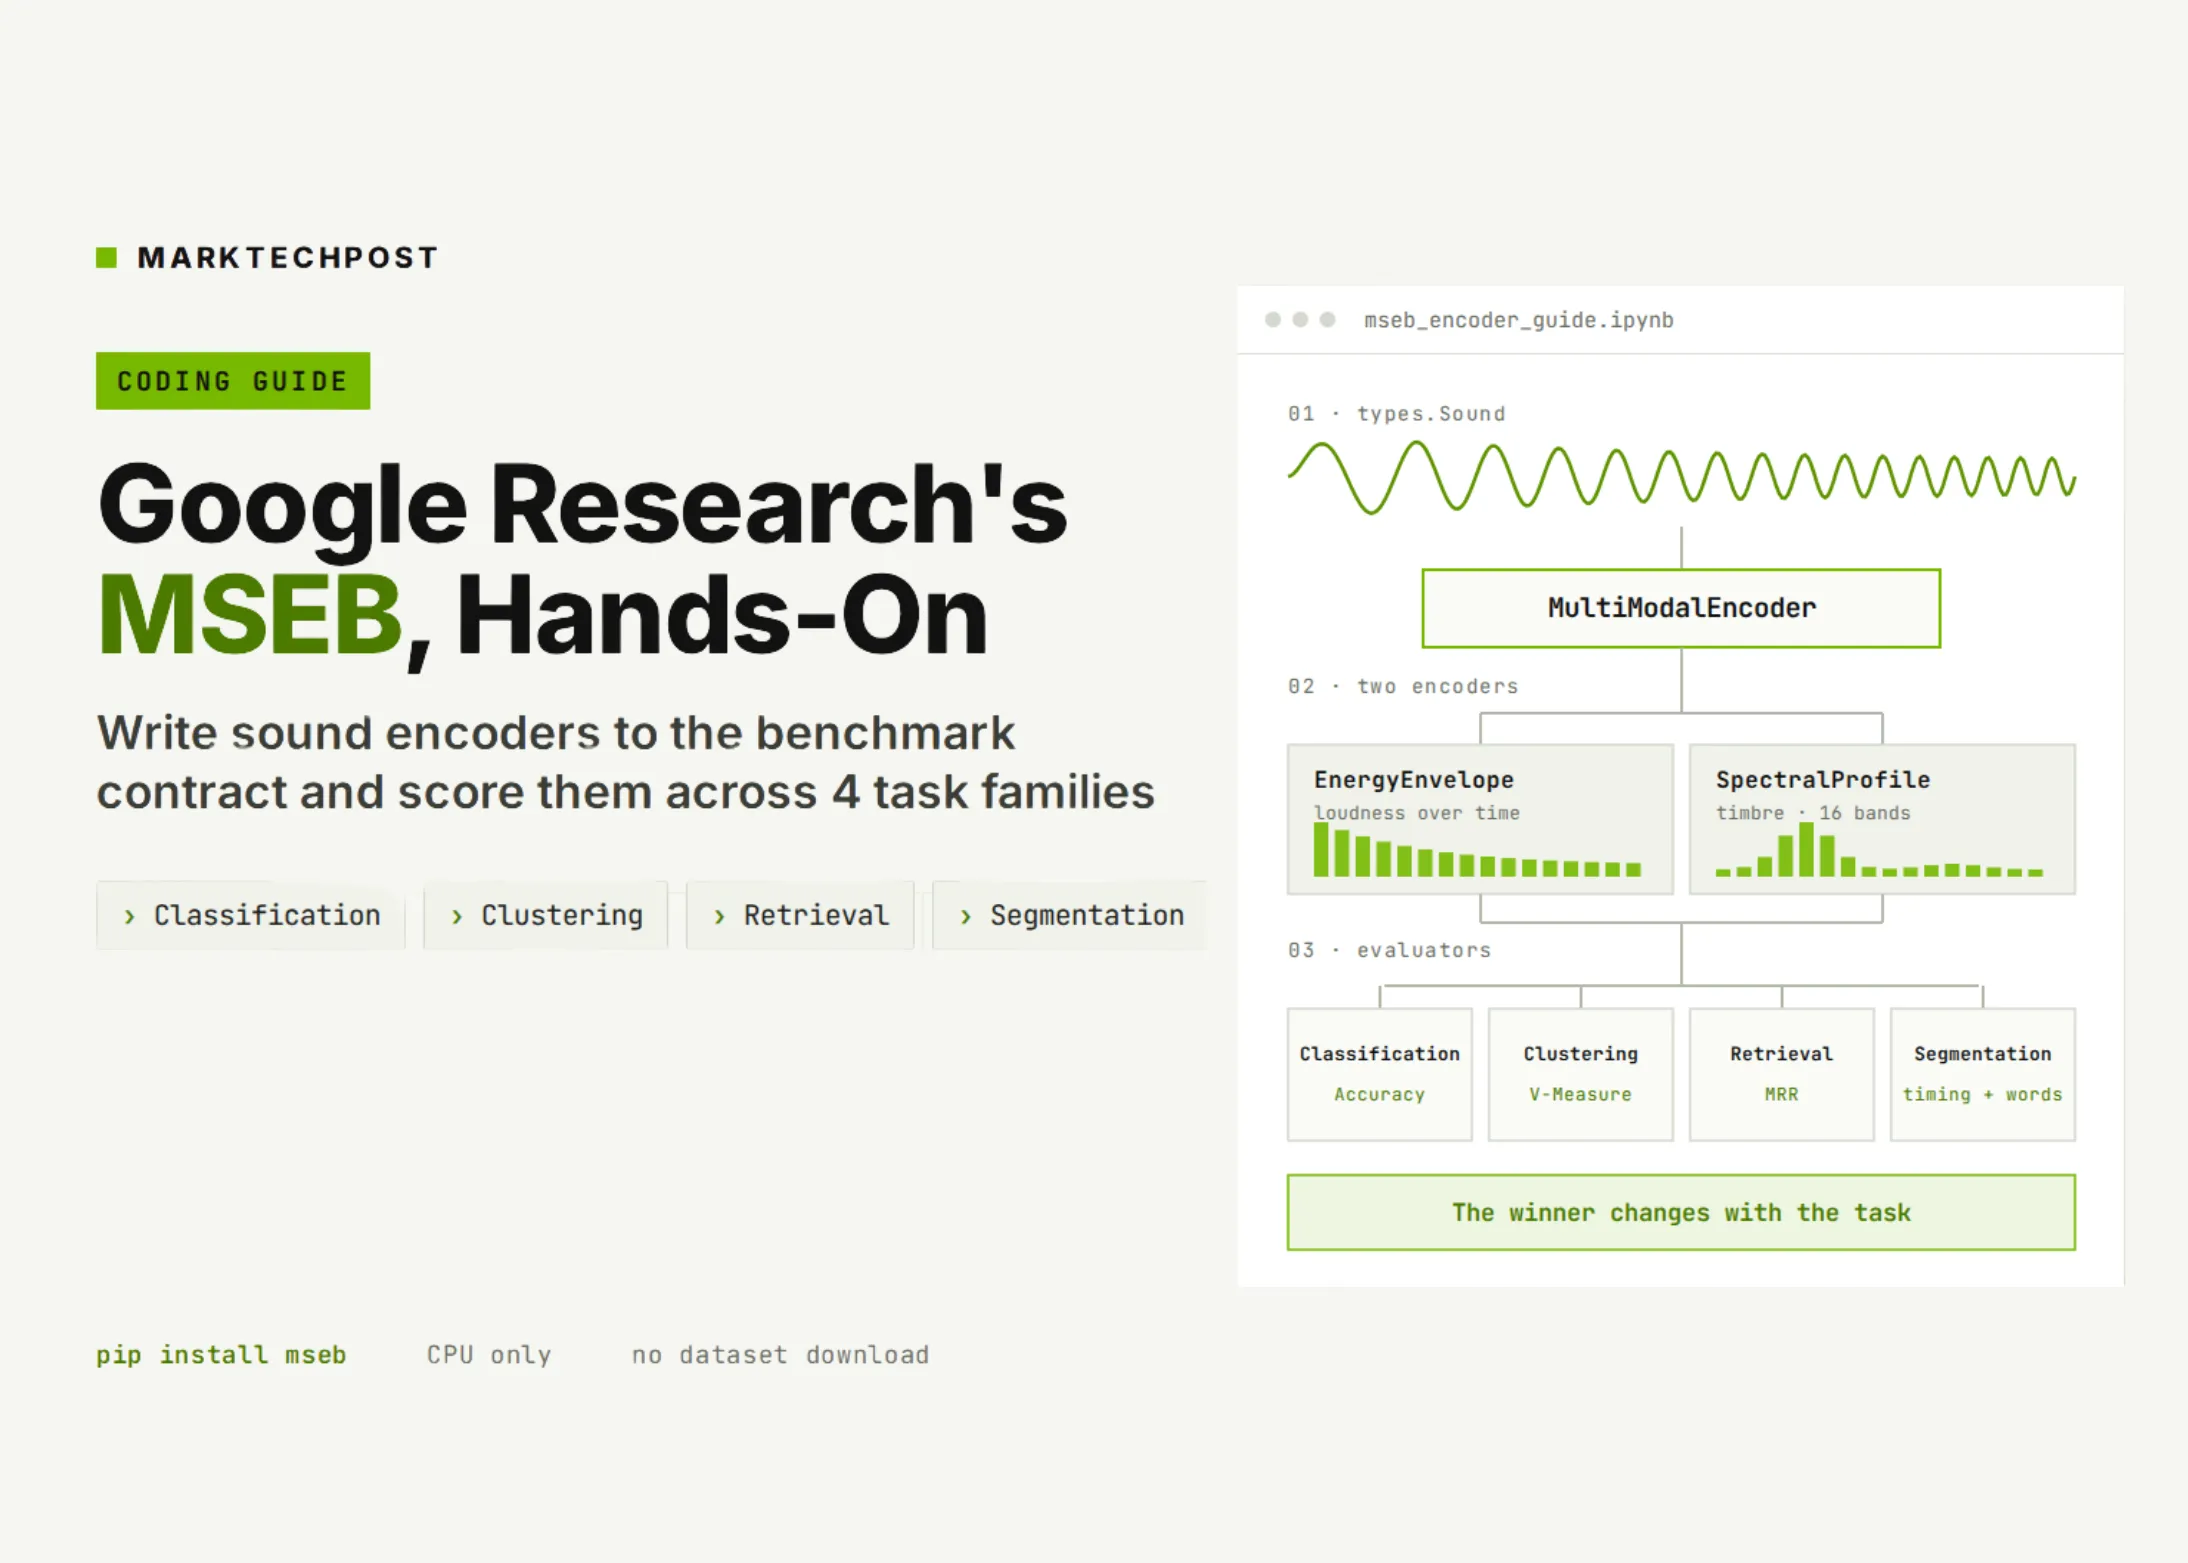
구글 리서치는 사운드 임베딩 평가 표준화를 위한 MSEB 벤치마크를 공개했다. 브라질 수퍼소닉 랩스는 1억 4,430만 파라미터의 경량 의사결정 모델 줄리아 1을 출시, 일부 벤치마크에서 우위를 보였다. 한편, 미국 메디케어 AI 프로그램 WISeR는 기술 문제와 환자 고통을 유발하며 논란에 직면했다.
핵심 기술 사양 및 성능 비교
구글 리서치의 MSEB(Massive Sound Embedding Benchmark)는 `mseb==0.1.0` 기반의 3계층(types, encoder, evaluators) 벤치마크로, 분류, 클러스터링, 검색, 분할 등 4가지 평가 도구로 음성 임베딩을 측정하며 다중 작업 벤치마크의 필요성을 수치로 제시한다. 수퍼소닉 랩스의 줄리아 1은 1억 4,430만 파라미터의 경량 의사결정 모델이다. 주요 기술 사양 및 벤치마크 결과는 다음과 같다:
- 파라미터 수: 1억 4,430만 개.
- 메모리 점유: FP32 가중치 550.5 MiB.
- 학습 비용: 약 R$540 (미화 $104.08).
- 벤치마크 성능 (H200 BF16, TypeSafe Jev 레퍼런스 비교):
- Typed Decisions: 73.15% (Julia 1) vs 72.70% (레퍼런스).
- AG News (4개 레이블): 94/100 (Julia 1) vs 91% (레퍼런스).
- DAIR Emotion (6개 레이블): 86/100 (Julia 1) vs 48% (레퍼런스).
- Banking77 (72개 레이블): 64/100 (Julia 1) vs 87% (레퍼런스).
산업 파급 효과
구글 MSEB는 사운드 AI 모델 평가 표준화를 통해 연구 효율성을 높인다. 줄리아 1은 낮은 학습 비용($104)과 경량 설계로 엣지 컴퓨팅 환경 AI 의사결정 시스템 도입을 가속화하며, 특정 분류 작업에서 높은 비용 효율성을 제공한다. 반면, 미국 메디케어 AI 프로그램 WISeR는 기술 오류 및 환자 고통을 야기하며, 공공 의료 서비스 AI 도입 시 엄격한 검증, 투명성, 사용자 중심 설계, 그리고 AI 거버넌스 및 규제 마련의 시급성을 강조한다.