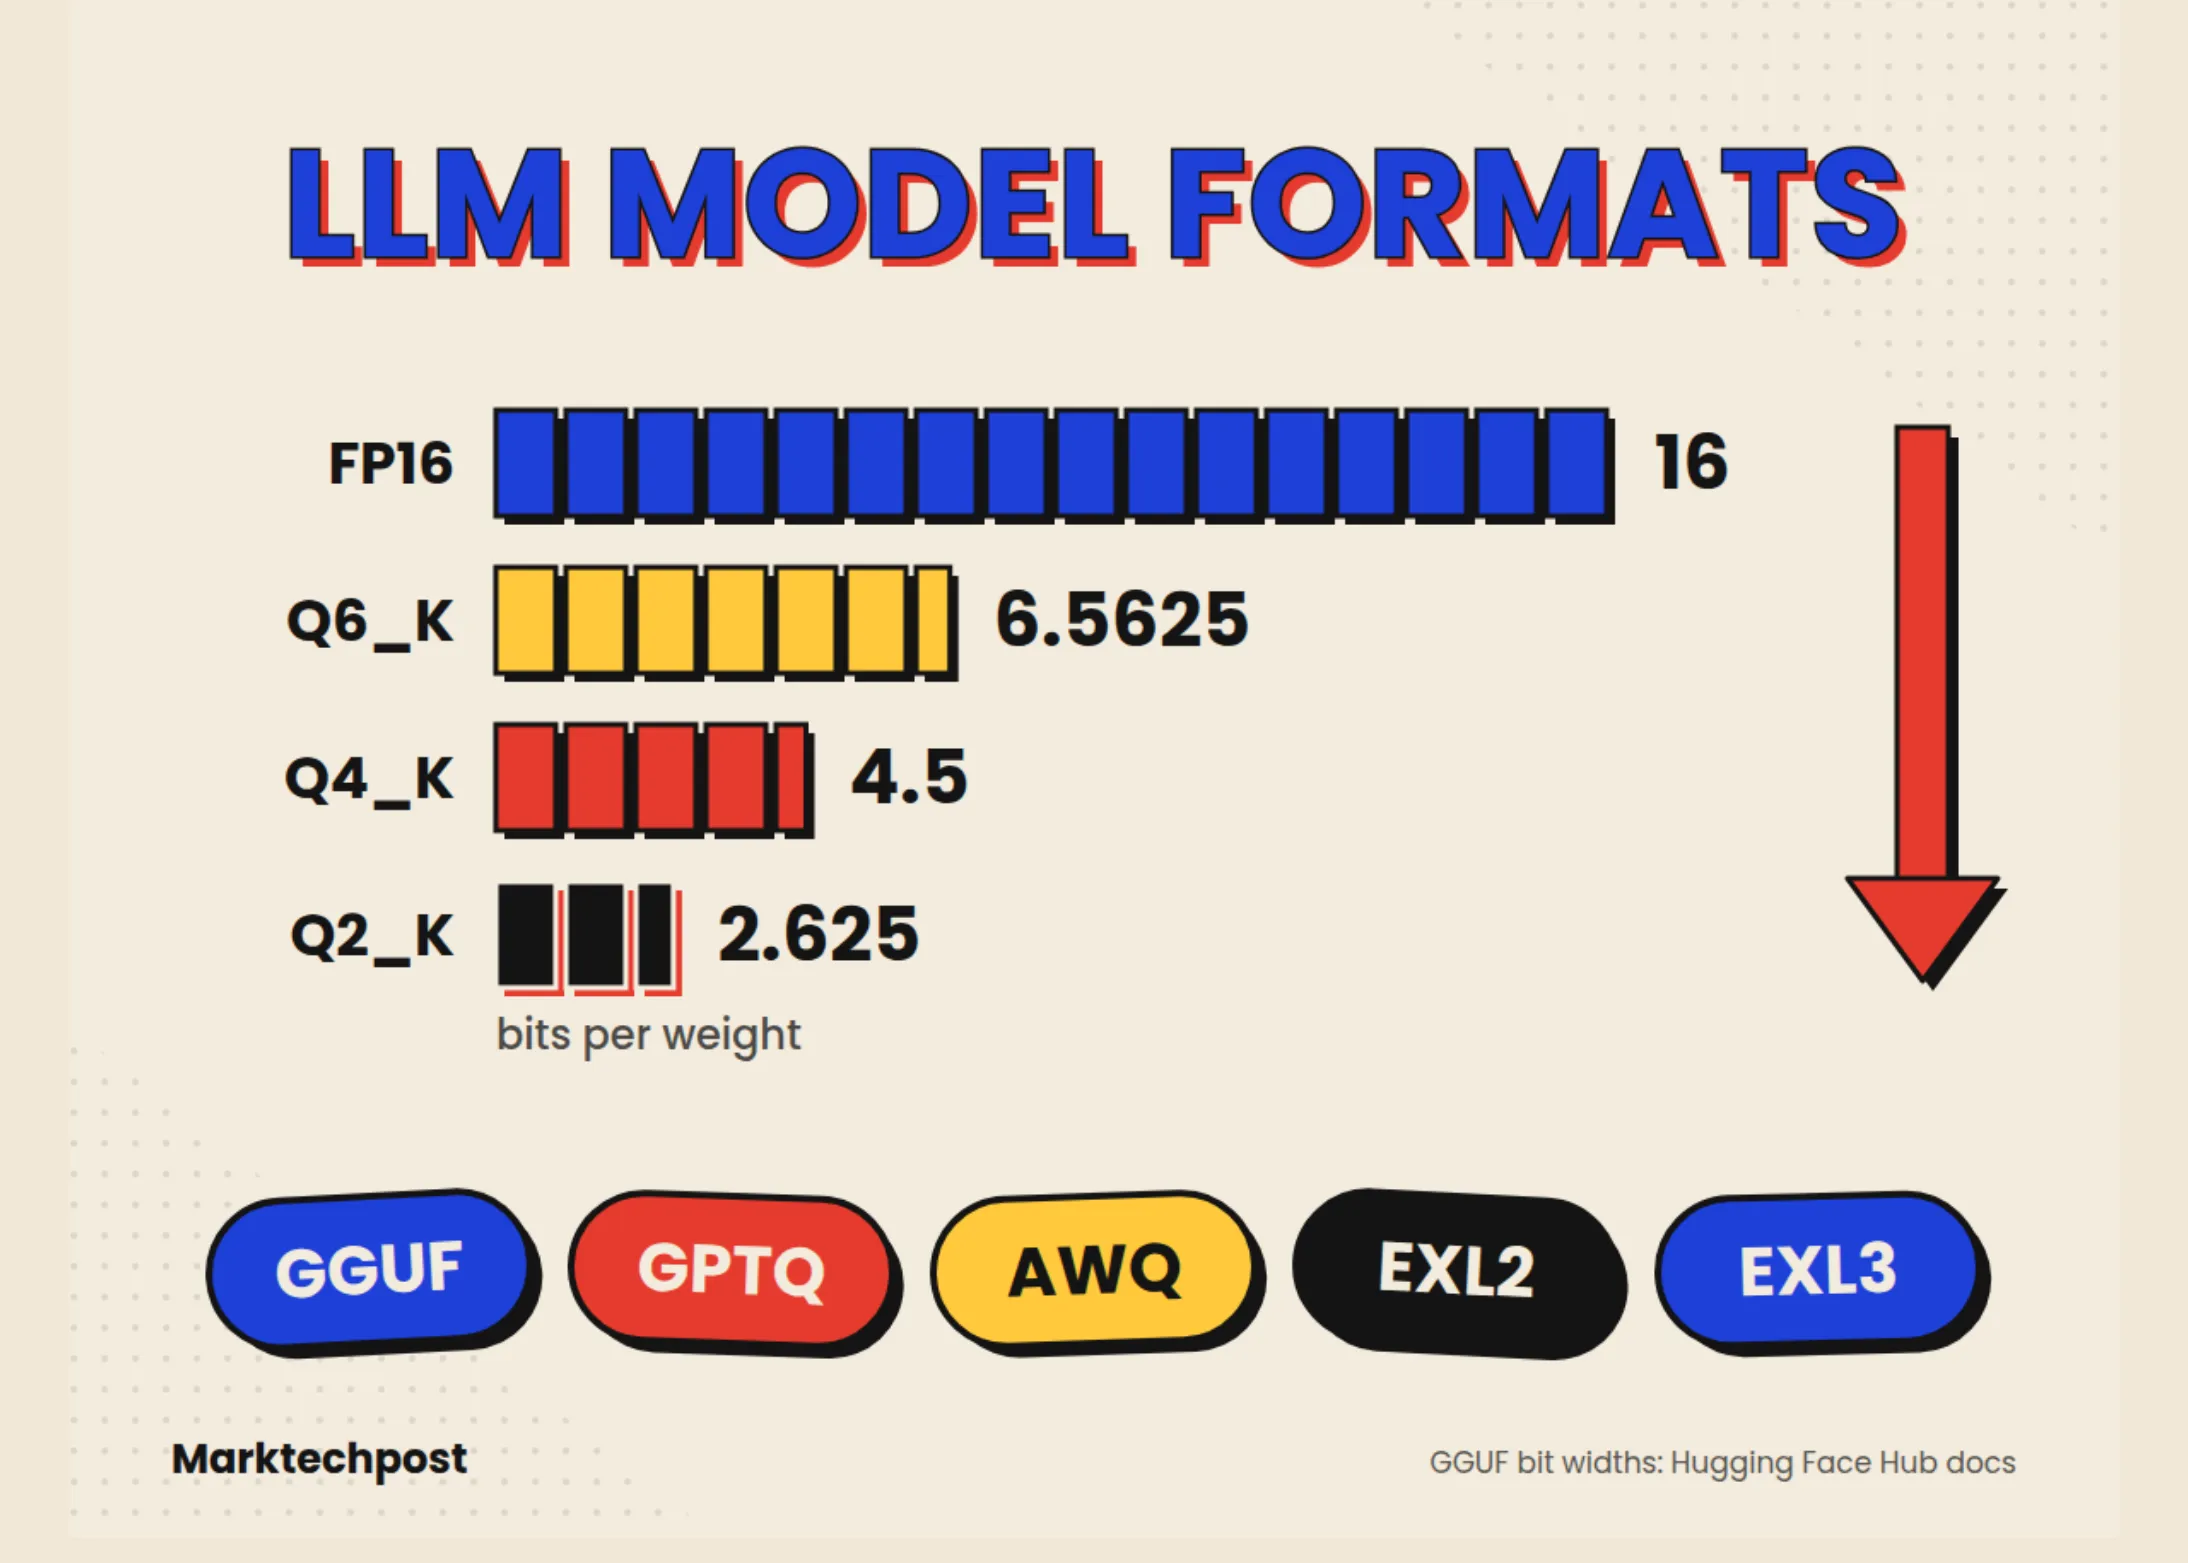
최근 AI 모델의 효율적인 배포와 운영을 위한 기술적 진전이 가속화되고 있습니다. 특히 모델 가중치 압축 방법인 양자화(quantization) 기술과 이를 담는 컨테이너 포맷이 발전하며, AI 모델의 경량화와 온디바이스(on-device) 실행 가능성이 확대되었습니다. 동시에 Meta는 로컬 파일 및 네이티브 앱과 연동되는 AI 에이전트 ‘Muse for Mac’을 출시하여 개인 생산성 분야에 AI 활용 범위를 넓혔습니다.
모델 경량화 기술 및 스토리지 포맷 분석
AI 모델의 효율적인 배포는 컨테이너 포맷과 양자화 방법에 의해 결정됩니다. 컨테이너는 텐서의 디스크 저장 방식을 정의하며, 양자화는 가중치를 적은 비트 수로 압축합니다.
- 컨테이너 포맷:
safetensors는 Hugging Face에서 개발되었으며, 기존PyTorch pickle (.bin/.pt)파일의 임의 코드 실행 보안 위험을 제거합니다. JSON 헤더와 원시 텐서 버퍼로 구성되며, 메모리 매핑을 통해 파일 전체를 읽지 않고 텐서를 개별 로드할 수 있습니다.GGUF는llama.cpp등 GGML 기반 실행기를 위한 바이너리 포맷으로, 2023년 8월 21일GGML을 대체했습니다. 키-값 메타데이터를 사용하여 확장성을 확보했으며, 모델 가중치 외에 토크나이저, 특수 토큰, 채팅 템플릿 등 완전한 정보를 단일 파일에 포함합니다. - 양자화 방법: GPTQ, AWQ, bitsandbytes NF4, llama.cpp K-quants 및 I-quants 등이 대표적입니다. 이들은 모델 가중치를 적은 비트 수로 압축하여 메모리 요구사항을 줄입니다.
- 메모리 효율성: 모델 가중치 메모리는
(파라미터 수 × 비트당 비트 수 ÷ 8)로 근사 계산됩니다. 예를 들어, 16비트 정밀도의 70억(8B) 파라미터 모델은 약 16GB, 700억(70B) 파라미터 모델은 약 140GB의 가중치 메모리를 필요로 합니다. 평균 4.5비트/가중치로 양자화된 경우, 70억 파라미터 모델은 약 4.5GB, 700억 파라미터 모델은 약 39GB로 메모리 요구량이 70% 이상 감소합니다. 이 수치는 가중치에만 해당하며, KV 캐시 및 런타임 오버헤드는 추가됩니다.
산업적 파급 효과 및 비즈니스 시사점
AI 모델 경량화 기술은 온디바이스 AI 및 클라우드 인프라 비용 절감에 핵심적인 역할을 합니다. GGUF와 같은 효율적인 컨테이너 포맷은 모델 배포의 단순성을 제공하며, 다양한 하드웨어 환경에서 AI 모델의 접근성을 높입니다. 이는 개발 비용과 운영 비용을 절감하여 AI 기술의 광범위한 상용화를 촉진합니다.
동시에 Meta의 ‘Muse for Mac’ 출시는 개인 컴퓨팅 환경에서 AI 에이전트의 실용적 활용 가능성을 제시합니다. Muse는 로컬 파일, 메일, 캘린더, 메시지 등 macOS 네이티브 앱과 연동하여 컨텍스트를 수집하고 작업을 수행합니다. 파일 정리, 양식 작성, 정보 요약 등 여러 앱에 걸친 일상 업무를 자동화하여 사용자 생산성을 향상시키는 데 초점을 맞춥니다. 사용자는 명시적인 옵트인(opt-in) 방식으로 접근 권한을 제어할 수 있으며, 파일 삭제나 메시지 전송과 같은 민감한 작업은 추가 승인을 요구하여 데이터 보안을 강화합니다. 이는 데이터 주권과 개인 정보 보호를 중시하는 AI 에이전트 개발 방향을 시사합니다.
한편, 뉴욕타임스(NYT)가 OpenAI 및 Microsoft를 상대로 제기한 저작권 소송에서 공개된 내부 문서는 AI 학습 데이터 수집 방식의 윤리적, 법적 문제를 부각했습니다. Microsoft의 내부 관계자는 데이터 스크래핑을 ‘인류 역사상 가장 큰 노동력 절도’로 언급하며, AI가 검색을 대체하여 웹 콘텐츠 원본 소스 방문을 줄이는 ‘둠 루프(doom loop)’를 유발할 수 있다고 경고했습니다. 이러한 논의는 AI 산업이 기술 발전을 넘어 데이터 소싱의 투명성과 저작권 보호라는 중대한 과제에 직면해 있음을 보여줍니다.