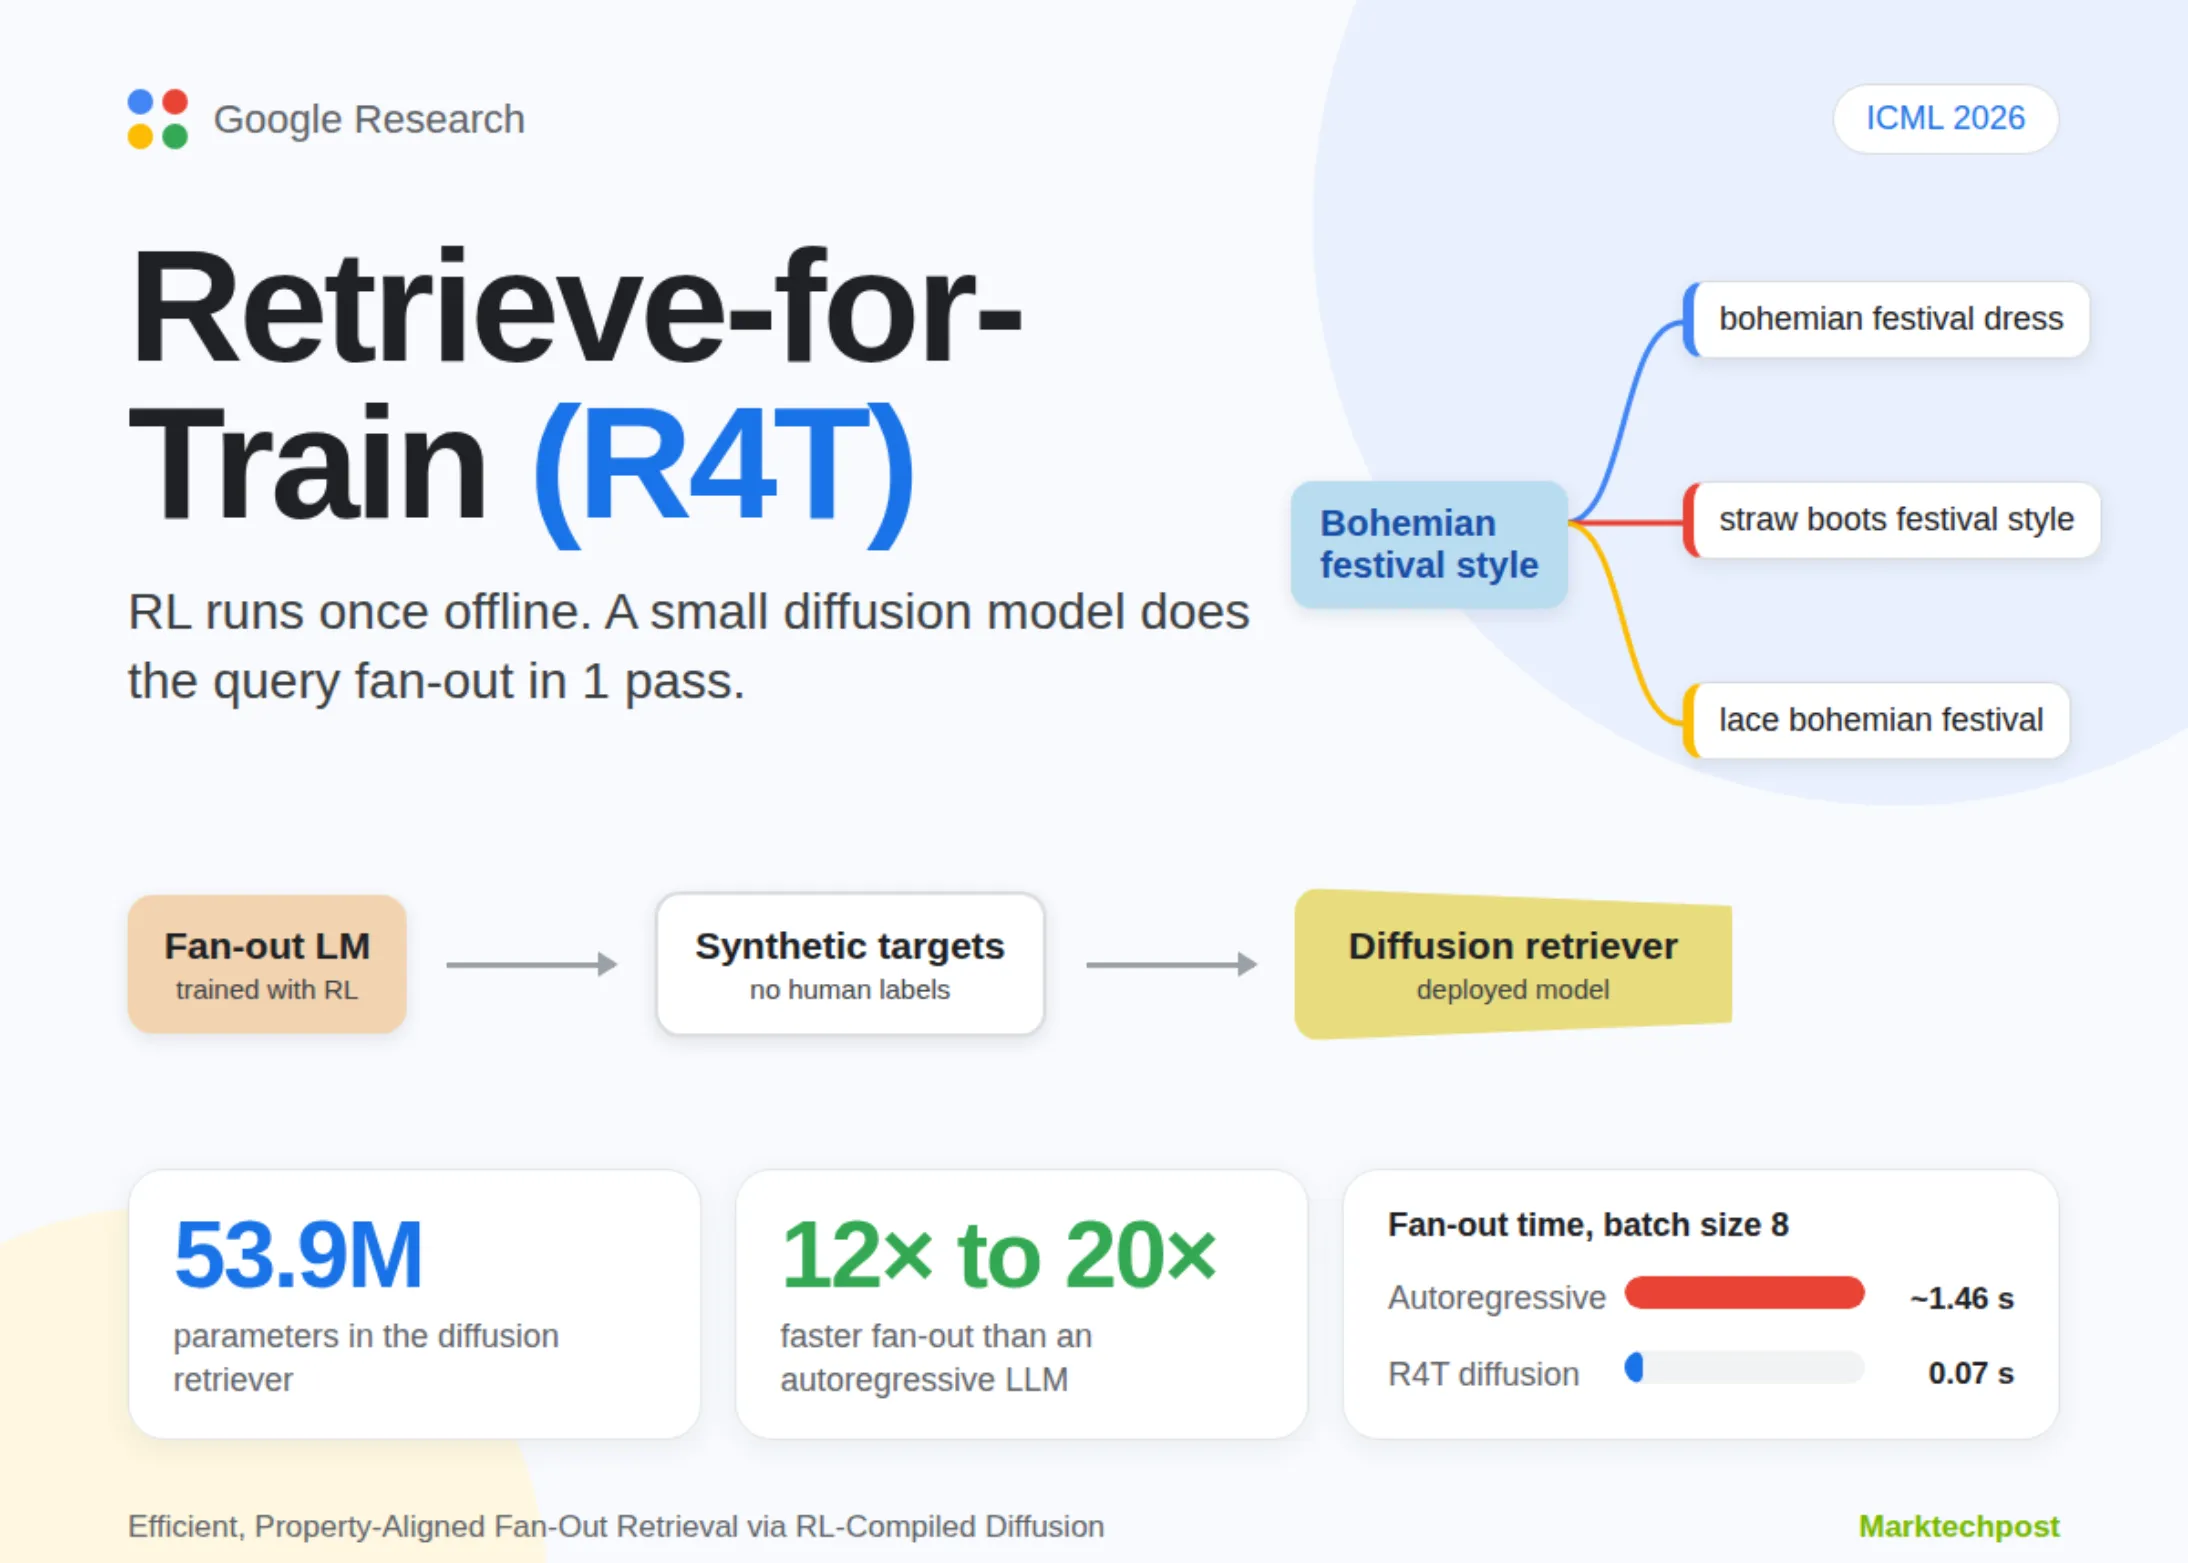
구글 리서치는 광범위한 검색 및 추천 시스템의 결과 다양성을 높이는 ‘Retrieve-for-Train(R4T)’ 프레임워크를 공개했다. 한편, 앤스로픽은 구글의 ‘SynthID-Text’ 워터마킹 기술을 클로드 모델에 적용할 계획을 발표했으며, 이 기술이 모델의 안전 장치에 미칠 수 있는 영향이 연구를 통해 드러났다. 스케일 AI는 한국 AI 안전 연구소와 협력하여 다국어 LLM 안전성 벤치마크 ‘ROK-FORTRESS’를 발표하며 한국어 프롬프트가 영어 대비 낮은 유해성을 보임을 확인했다.
핵심 기술 사양 및 성능 분석
- 구글 R4T 프레임워크: 단일 검색어로 여러 결과 세트를 효율적으로 반환하기 위해 설계되었다.
- 기술 메커니즘: 강화 학습(RL)으로 쿼리 팬아웃(fan-out)을 학습한 뒤, 5,390만 개 파라미터의 확산 트랜스포머(diffusion transformer) 모델에 행동을 증류(distill)한다. 이 모델은 단일 비자기회귀적(non-autoregressive) 패스로 모든 검색 방향 임베딩을 생성한다.
- 기존 한계 해결: ‘Bohemian festival style’과 같은 광범위한 프롬프트에서 발생하는 유사어 반복(paraphrastic collapse)과 느린 추론(latency) 문제를 해결한다.
- 보상 설계: 검색된 세트 전체에 대한 보상을 사용하며, 접지성(Groundedness, λg=0.6), 다양성(Diversity, λd=0.2), 정렬성(Alignment, λa=0.2)을 가중치로 조합한다.
- SynthID-Text 워터마킹: 구글이 개발하고 오픈 소스로 공개한 생성형 AI 콘텐츠 워터마킹 기술이다.
- 기술 메커니즘: 비밀 키를 사용하여 모델이 다음 단어를 선택하는 과정에 미묘한 변화를 준다. 이는 무작위 시드 생성기, 샘플링 알고리즘, 점수 함수를 추가하여 이루어진다.
- 새로운 연구 결과: 워터마킹이 단어 선택뿐만 아니라 모델의 도구 호출 방식 및 안전 장치 준수 여부에도 영향을 미칠 수 있음을 보여준다. 특히 적대적 조건(adversarial conditions) 하에서 모델이 평소 따르지 않던 지시를 수행할 가능성이 증가한다.
- ROK-FORTRESS 벤치마크: 스케일 AI와 한국 AI 안전 연구소가 공동 개발한 이중 언어(영어-한국어) LLM 안전성 벤치마크다.
- 평가 범위: 14개 최신 모델을 대상으로 1,235개 태스크를 평가했다. 화학, 생물학, 방사능, 핵, 폭발물(CBRNE) 위협, 정치적 폭력 및 테러리즘, 범죄 및 금융 활동, 정보 유출 등 4가지 국가 안보 및 공공 안전 도메인을 포함한다.
- 주요 발견: 한국어 프롬프트와 한국적 맥락은 거의 모든 모델에서 일관되게 낮은 유해성 점수(measured harm)와 관련이 있었다. 가장 유해한 모델과 가장 덜 유해한 모델 간의 위험 점수(tier-weighted risk score) 차이는 거의 9배에 달했다.
- 방법론: 언어(영어 vs. 한국어)와 지정학적 접지(미국 vs. 한국적 맥락)를 독립적으로 변화시키는 ‘통제된 트랜스크리에이션 매트릭스’ 방식을 사용했다.
산업 및 비즈니스 파급 효과
이러한 기술 발전은 다양한 산업 분야에 광범위한 영향을 미칠 것으로 분석된다.
- 검색 및 추천 시스템의 진화: 구글 R4T는 전자상거래, 미디어 콘텐츠 등에서 사용자 질의에 대한 더욱 관련성 높고 다양한 결과 세트 제공을 가능하게 한다. 이는 사용자 경험 개선, 잠재적으로는 전환율 증가 및 플랫폼 효율성 향상으로 이어진다. 대규모 언어 모델 기반 검색 시스템의 지연 시간 단축은 실시간 서비스에 중요한 이점을 제공한다.
- AI 콘텐츠 출처 투명성 및 안전성 확보 과제: SynthID-Text와 같은 워터마킹 기술은 생성형 AI 콘텐츠의 신뢰성 및 출처 검증에 필수적이다. 그러나 워터마킹이 모델의 안전 장치와 도구 호출 기능에 미치는 예기치 않은 영향은 개발자들이 AI 모델 배포 전 광범위한 테스트를 수행해야 함을 시사한다. 특히 에이전트 기반 AI 시스템이나 고위험 애플리케이션에서는 이러한 행동 변화에 대한 면밀한 검토가 요구된다.
- 글로벌 AI 안전성 표준 및 현지화의 중요성: ROK-FORTRESS 벤치마크 결과는 AI 안전성 평가 시 언어적, 문화적 맥락의 중요성을 강조한다. 이는 다국어 및 다문화 시장에 AI 서비스를 배포하는 기업들에게 표준 번역 방식으로는 충분하지 않으며, 현지화된 안전성 벤치마킹 및 레드팀(red-teaming) 활동이 필수적임을 시사한다. 이러한 접근은 잠재적인 평판 손상이나 규제 문제를 예방하고, AI의 윤리적이고 안전한 글로벌 확산을 지원하는 데 기여할 것이다.